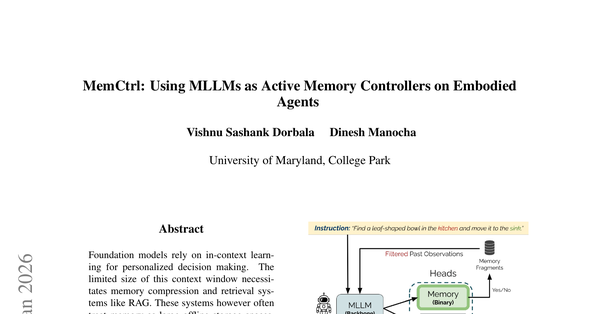
MemCtrl: Using MLLMs as Active Memory Controllers on Embodied Agents
要約
論文タイトル:MemCtrl: Using MLLMs as Active Memory Controllers on Embodied Agents
論文掲載雑誌名:arXiv preprint arXiv:2601.20831 (cs.AI)
論文発行年月:202601
# 概要(Abstract)
- 基盤モデルは個別化された意思決定を文脈内学習に頼るが、文脈窓のサイズが限られるためRAGのようなメモリ圧縮・検索が必要になる。これらは大規模オフライン保存を前提とし、厳しいメモリ・計算制約下でオンライン動作する身体性エージェントには不向き。
- 本研究はMLLM(マルチモーダル大規模言語モデル)を用いてメモリをオンラインで剪定する新フレームワーク MemCtrl を提案。学習可能なメモリヘッド µ をゲートとして付加し、探索中にどの観測・反省を保持/更新/破棄するかを決定する。
- µ を①オフライン専門家、②オンラインRL の2方式で学習。EmbodiedBenchの複数サブセットで低性能MLLM 2種を µ で拡張したところ、平均約16%(特定の指示サブセットでは20%超)改善した。
# 1. はじめに(Introduction)
- 身体性AIの目標は多様なタスク・環境・指示で高成功率を出す汎用エージェント。基盤モデルを使う枠組みが一般的だが、大規模学習コスト・分布外への適応困難・エッジ計算の制約が課題。
- 代替策はメモリバンクと基盤モデルを組み合わせるモジュール型だが、身体性ロボットは小型モデル(<20Bパラメータ)でローカル動作し、転送可能で軽量なモジュールが望ましい。
- 人間が全観測を蓄積せず重要な断片だけを能動的に選別する点に着想を得て、小型エージェントにも「書き込み時に重要なメモリを残し冗長なものを捨てる」能力を持たせることを目指す。
# 2. 関連研究(Related Work)
- 2.1 身体性AIにおけるMLLM:SayCan(固定スキル依存)、PaLM-E(大量学習データ必要)、RT-2(明示的メモリなしの短い時間文脈)等を概観。本研究はMLLMを能動的メモリ制御器として使い、小型モデルで長期タスクを扱う点で異なる。
- 2.2 メモリ拡張エージェント:LLMを「ロボットの脳」とするMai et al.、対話-行動例を検索するHELPER[Sarch]等。これらは基盤モデルが受動的でメモリ投入に別モジュールを要するのに対し、MemCtrlはMLLM自身が保存可否を能動制御する。
# 3. MLLMベースの身体性エージェント
- ベースラインはM(Oc, I)で観測と指示から行動を生成するゼロショット方式だが、継続的文脈がなく性能が低い。
- 3.1 メモリ拡張MLLMエージェント:過去の観測・反省を文脈Cとして与えると性能向上するが、文脈窓hの制約(n<h)がある。検索関数Fで圧縮するが、文脈サイズnの増大で検索が非効率化(ロボットは高頻度で観測を収集)。書き込み時メモリ制御の必要性を指摘。
# 4. MemCtrl: メモリヘッド(µ)の学習
- 学習可能なメモリヘッド µ を二値分類器として導入し、現観測を保存(b=1)か破棄(b=0)かをオンライン決定。µ はモデル非依存で任意のMLLMに付加でき、バックボーンの微調整・編集が不要。
- 学習方法は2つ:①オフライン完全教師あり(高性能MLLM=GPT-4oから専門家データを収集し、成功/失敗で二値分類器を学習、二値交差エントロピー損失)、②オンラインRR(行動ヘッドとメモリヘッドをREINFORCEで学習。エピソード成功のスパース報酬+有効行動のデンス報酬)。
# 5. 実験設定(Experimental Setup)
- データセット:EmbodiedBench(ALFRED・Habitatシミュレータの自動評価ツール)にメモリヘッドを組み込んで使用。
- LLMバックボーン:EmbodiedBenchで低性能なQwen2.5-VL-7B-InsとGemma-3-12B-ITを選び、NVIDIA A5000上でローカル実行。
- メモリヘッド:3層MLP。オフライン版はGPT-4o(EB-ALFRED 56.3%/EB-Habitat 59.0%)で専門家データを収集し交差エントロピーで学習、オンライン版はREINFORCEで学習。
# 6. 結果(Results)
- µ追加で EB-ALFRED・EB-Habitat 両方で性能向上。特に長い指示(Long)で大きく改善(Gemma 12→26、Qwen 2→24)。複雑な指示(Complex)でもQwenが6→21と3倍に。
- 低性能なQwen2.5への性能向上幅が大きく、µRL付与で約2倍規模のOvis2-16Bに匹敵。
- ALFRED(操作中心)よりHabitat(ナビゲーション中心・長期計画)の方が全体的に高性能で、メモリ選別は長期ナビゲーションでより有効と推察。
# 7. 定性分析(Qualitative Analysis)
- ベース課題ではQwen+µRLがGPT-4oに匹敵する性能を少ない手数で達成。
- 長期課題では4手法とも完遂できず:ゼロショット専門家は早期終了、完全メモリは文脈過多で誤行動、µRLは探索的(新オブジェクトを置き続ける)、µExpertは搾取的(同じ活動を繰り返す)と、それぞれ特徴的な挙動を示した。
# 8. 結論(Conclusions)
- MemCtrlは、MLLMを直接編集せずRAGのような外部検索も使わず、メモリヘッド µ を二値分類器として学習し重要なメモリを能動選別する軽量・転送可能な枠組み。
- ALFRED・Habitatで平均約16%の性能改善、特に複雑/長期の指示で優れた性能を示した。
# 9. 限界(Limitations)
- 教師あり版は強力なモデルの専門家デモを要し、RL版はスパース報酬の非効率性を抱える。短期課題では利得が小さい。観測の「面白さ」を捉える報酬設計、音声観測の取り込み、実機転移が今後の課題。
評価
論文タイトル:MemCtrl: Using MLLMs as Active Memory Controllers on Embodied Agents
論文掲載雑誌名:arXiv preprint arXiv:2601.20831 (cs.AI)
論文発行年月:202601
# 新規性
- 身体性エージェントのメモリ管理を、MLLMに付加した学習可能な「メモリヘッド µ」でオンライン・書き込み時に能動制御する点が新規
- RAG等が大規模オフライン保存からの「読み出し時」検索を前提とするのに対し、MemCtrlは観測を保存する時点で重要性を判断し冗長なものを捨てる。人間が重要な断片だけを能動的に記憶する仕組みに着想
- µ はモデル非依存・転送可能なヘッドで、バックボーンMLLMを微調整・編集せずに任意のMLLMへ着脱できる設計。小型モデル・エッジ計算という制約に適合
# 言及されている全ての関連研究との相違点
- 身体性AIのLLM計画(SayCan、PaLM-E、RT-2)は固定スキル依存・大量学習・明示的メモリ欠如といった制約があり、本研究は能動的メモリ制御器として長期タスクを小型モデルで扱う点で差別化
- メモリ拡張(LLMを脳とするMai、対話例を検索するHELPER[Sarch]、MemGPT、Voyager、MemoryBank等)が基盤モデルを受動的にしメモリ投入に別モジュールを要するのに対し、MemCtrlはMLLM自身が保存可否を能動決定する点が異なる。RAGや内在的モデル編集(Mitchell, Meng)とも対比
# 有効性
- EmbodiedBench(ALFRED・Habitat)で低性能なQwen2.5-VL-7B・Gemma-3-12Bを µ で拡張し平均約16%改善。特に長い指示(Gemma 12→26、Qwen 2→24)・複雑な指示(Qwen 6→21)で大きな向上を確認
- 完全メモリ(全観測保持)との比較で選択的メモリ(µRL)の優位を示し、メモリ効率・無効行動数の統計で裏付け。Qwen2.5+µRLが2倍規模のOvis2-16Bに匹敵し、定性分析でµRL(探索的)とµExpert(搾取的)の挙動差も提示
- ただし対象は低性能2モデル・EmbodiedBench上のみで、実機評価はなし。教師あり版は強力モデル(GPT-4o)の専門家デモを要し、RL版はスパース報酬の非効率を抱え、短期課題では利得が小さいと著者が明示。長期課題では4手法とも完遂できない例も示された
# 信頼性
- arXivプレプリント(査読前、2026年1月投稿)。University of Marylandの研究で、定量(5サブセット×2ベンチ)・定性・メモリ効率/無効行動の統計・アルゴリズム/プロンプト/デコーダ修正まで付録に詳細を開示し再現性に配慮
- 一方、査読を経ておらず、評価は2つの低性能モデルとシミュレータ(EmbodiedBench)に限定。実機転移・音声観測・報酬設計の改善はいずれも今後の課題で、汎化性能や実運用での有効性は未検証。結論は「能動的メモリ選別が小型身体性エージェントの性能を平均16%改善しうる」という提案+実験的裏付けの段階
和訳
![]()
1 / 1
100%