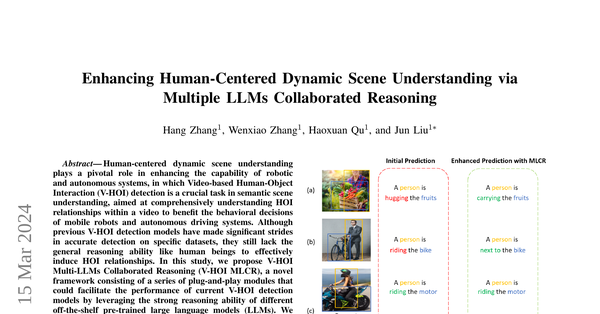
Enhancing Human-Centered Dynamic Scene Understanding via Multiple LLMs Collaborated Reasoning
要約
# 章1 イントロダクション
- 動的なシーン理解は、ロボットや自律走行システムの行動決定に重要な役割を果たす。
- Video-based Human-Object Interaction \(V-HOI\) 検出は、セマンティックなシーン理解の重要なタスクである。
- 既存のV-HOI検出モデルは特定のデータセットで高い精度を達成しているが、HOI関係の効果的な推論に必要な人間のような一般的な推論能力が欠けている。
- 本研究では、複数の大規模言語モデル \(LLMs\) を活用し、現在のV-HOI検出モデルの性能を向上させるプラグアンドプレイ型のモジュールからなるV-HOI Multi-LLMs Collaborated Reasoning \(V-HOI MLCR\) を提案する。
- 異なるLLMの強力な推論能力を活用するために、V-HOIタスクのための2段階のLLMコラボレーションシステムを設計した。
- 第1段階では、異なる観点から推論を行うためにLLMを活用するCross-Agents Reasoning schemeを設計した。
- 第2段階では、異なるLLMの知識に基づいて最終的な推論結果を得るためのMulti-LLMs Debateを行う。
- さらに、大規模なビジョン言語モデルであるCLIPを用いて、ベースとなるV-HOIモデルの識別能力を向上させ、LLMとの協調性を高めるための補助的な学習戦略を考案した。
# 章2 関連研究
- HOI検出
- 2段階法と1段階法がある。
- 2段階法は物体検出の後に人物-物体ペアの相互作用を推定する。
- 1段階法は物体検出と相互作用推定を同時に行う。
- 画像ベースの手法は時間的な動きを無視する傾向があり、時間に敏感な相互作用の識別が困難である。
- V-HOIを扱う手法が提案されており、画像ベース手法より優れた性能を示している。
- 既存のHOI検出モデルは、人間のような強力な常識的推論能力が不足している。
- 大規模言語モデル \(LLMs\) からの推論
- LLMsは自然言語処理の様々なタスクで優れた性能を示している。
- LLMsの推論は直感、経験、常識に依存した非構造的な方法であることが多い。
- LLMsにグラウンディング情報を組み込むことで、推論能力が向上することが多い。
- LLMsは空間関係の機能的・幾何学的バイアスを認識する能力がある。
- LayoutGPTは視覚的な計画におけるLLMsの能力を示している。
# 章3 問題定義
- V-HOI検出タスクは、ビデオ内の各フレームにおいて、人物bt,iと物体bt,jのバウンディングボックス、物体クラスcobj t,j 、相互作用クラスcinter t,⟨i,j⟩を予測する。
- 現在の手法は通常、エンコーダで相互作用の埋め込みf interを取得し、予測ヘッドに入力して相互作用クラスの確率スコアsinter ∈ \[0, 1\]Nを予測する。
# 章4 手法の概要
- 提案手法V-HOI MLCRの概要は以下の通り。
- 現在のSOTAなV-HOI検出モデルを用いて、各フレームの初期予測トリプレットを取得する。
- トリプレットをテキスト形式に変換し、LLMベースのコラボレーションシステムに入力する。
- LLMベースのコラボレーションシステムは2段階で構成される。
- Cross-Agents Reasoning: 各LLM内に異なるエージェントを定義し、予測の合理性をチェックする。
- Multi-LLMs Debate: 異なるLLMからの応答をマルチLLMデバッター形式で統合し、最終予測を得る。
# 章5 Cross-Agents Reasoning
- 各LLMをクロスアスペクト推論エージェントとして活用し、現在のV-HOI検出モデルの予測精度を向上させる。
- 3つの推論エージェントを設計: 常識、空間、時間推論エージェント。
- 各エージェントは現在のHOI予測を評価するようプロンプトされる。
- プロンプトはタスク説明(Instruction)、デモ(Demonstrations)、テストインスタンス(Test)から構成される。
- 常識推論エージェント
- 予測されたHOIトリプレットが常識的に合理的かどうかをスコア付けする。
- タスク説明、デモ、テストインスタンスの具体例が示されている。
- 空間推論エージェント
- 主体と客体の空間的な位置関係を考慮して、予測されたHOIが合理的かどうかをチェックする。
- 2段階で構成: 予測されたアクションが空間的に意味があるかどうかの判定と、主体・客体の位置に基づいた合理性のスコア付け。
- 時間推論エージェント
- 2つのフレーム間で変化するトリプレットに対してのみ適用される。
- 変化が合理的かどうかをチェックする。
- 最終的に各エージェントのスコアを統合して最終スコアを計算する。
# 章6 Multi-LLMs Debate
- 異なるLLMの知識を活用するために、複数のLLMを使用する。
- LLMの推論は時に不正確な答えを出すことがあるため、外部フィードバックなしでは自己修正が難しい。
- そこで、異なるLLMからの応答を統合するためのデバート方式を導入する。
- LLMをデバッターとして指定し、各LLMが順番に議論の履歴を踏まえて応答する。
- 別のLLMを審判役として指定し、デバッターからの応答を統合して最終的な答えを導き出す。
- 最も強力なLLMであるChatGPTを審判役とする。
# 章7 CLIPによる補助学習
- LLMとのシームレスな統合のために、予測モデル自体の内部推論能力を高める必要がある。
- 強力な内部教師としてCLIPを用いる補助学習戦略を提案。
- 正解のHOIトリプレットをテキスト形式に変換してCLIPのテキスト埋め込みを生成。
- V-HOIモデルの特徴抽出層の末尾で対応するトリプレット特徴との正則化を行う。
- CLIPによる強すぎる教師はオリジナルの学習目標を乱す可能性があるため、ロス関数の重みを調整する。
# 章8 実験
- データセット&評価指標
- Action Genome \(AG\) データセット: 1人のシナリオ
- VidHOIデータセット: 複数人のシナリオ
- Recall@Kを評価指標として使用
- 実装詳細&ベースライン
- ChatGPT-4.0、LLaMA2 \(70B\)、PaLM2 \(Bison\) を使用
- STTranGazeとSTTranをベースラインとして使用
- 隣接フレーム間の差が小さいため、一定間隔でサンプリングしたキーフレームに対してのみLLMに問い合わせる
- 実験結果
- ベースラインと比較して、MLCRを適用することで優れた性能を達成
- AGデータセットではR@50で大きな性能向上
- VidHOIデータセットでもR@50で最大の性能向上
- アブレーション実験
- 提案手法の各コンポーネントの有効性を検証
- CLIP学習戦略、常識エージェント、空間エージェント、時間エージェント、デバート方式のいずれも性能向上に寄与
- 可視化
- 複数のLLMによる協調推論の優位性を直感的に示すサンプルを提示
- LLMのスコアにより、正解トリプレットのスコアが閾値を超えて正しく認識されるようになる
# 章9 結論
- 人間中心の動的シーン理解のための新しいフレームワークV-HOI MLCRを提案
- 既存のV-HOIモデルと外部エキスパートとしてのLLMを協調させ、推論能力を高める
- ベースモデルの強化のためにCLIPを用いた補助学習方式を提案
- 提案フレームワークはシンプルかつ効果的で、プラグアンドプレイ方式で使用可能
- Action GenomeとVidHOIデータセットで優れた性能を達成
評価
# 新規性
- 本研究では、異なる大規模言語モデル(LLMs)を利用してビデオ内の人物-物体インタラクション(V-HOI)を理解する新しいフレームワーク「V-HOI Multi-LLMs Collaborated Reasoning (V-HOI MLCR)」を提案している。これは、複数のLLMを活用し、それぞれのモデルが持つ豊富で多様な知識を組み合わせることで、V-HOIモデルの推論能力を向上させる。
# 言及されている全ての関連研究との相違点
- 従来の研究では主に静止画像内のHOI検出に焦点を当てていたが、本研究は動的なビデオシーンを対象としており、時間的ダイナミクスを考慮に入れている。さらに、複数のLLMを用いることで、それぞれのモデルが提供する知識を活用し、より豊富な推論を行う点が異なる。また、空間的・時間的整合性を評価するための「Cross-Agents Reasoning」と「Multi-LLMs Debate」という二段階のコラボレーションスキームを導入している。
# 有効性
- 本研究で提案されているV-HOI MLCRフレームワークは、基本的なV-HOIモデルの予測精度を向上させることが実験により確認されている。特に、異なる視点からの推論を行うことで、より正確な人物-物体間のインタラクションの予測が可能になる。実験結果は、V-HOI MLCRが他の最先端モデルよりも優れた性能を示している。
# 信頼性
- 提案されているフレームワークは、複数のLLMを利用しており、各LLMが独自の知識と推論能力を持っているため、バイアスの影響を受けにくく、より一般化された予測が可能である。さらに、CLIPを用いた補助的なトレーニング戦略によって、ベースとなるV-HOIモデルの識別能力が強化されており、結果として全体的な信頼性が向上している。
和訳
![]()
1 / 1
100%