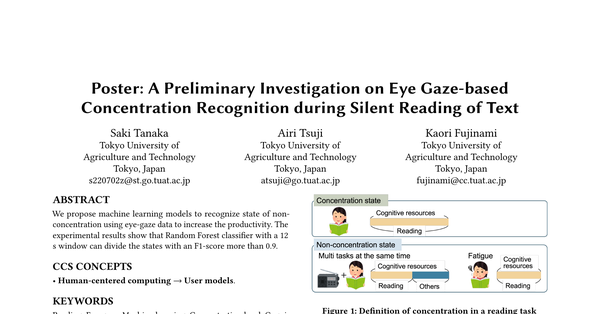
Poster: A Preliminary Investigation on Eye Gaze-based Concentration Recognition during Silent Reading of Text
要約
- タイトル: テキストの黙読中における視線に基づく集中度認識の予備的調査
- 著者: 辻愛梨、田中沙季、藤波香織(東京農工大学)
- 要旨: 認知リソースを増やすために視線データを使用して非集中状態を認識する機械学習モデルを提案。12秒のウィンドウを持つランダムフォレスト分類器はF1スコア0.9以上で状態を分類できることを実験結果で示した。
- キーワード: 読書、視線、機械学習、集中度、認知リソース
- 1. 紹介: 生産性向上のために非集中状態を検出し、作業者に休憩を促すシステムを提案。視線情報を使用して読書中の集中度と非集中度を機械学習で認識する方法を検証。
- 2. 方法: 集中度を認識するための認知リソースの割り当てを定義。読書中の認知リソースの割り当てに基づいて集中度と非集中度を区別。集中、抑制、疲労の3つの実験条件を準備。
- 3. データ収集: 20代の13人の学生の読書中の視線データを収集。集中、抑制、疲労の実験条件で実施。
- 4. 分類特徴: 読書中の視線データから69の特徴量を計算。集中度認識のための機械学習モデルの評価。
- 5. 評価: 異なるパラメータの影響を理解するために実験を実施。ランダムフォレスト分類器と12秒のウィンドウが最も高いF1スコアを達成。
- 6. 結論: 黙読中の集中度と非集中度を視線動きに基づいて区別するための予備的研究を実施。ランダムフォレスト分類器が最も優れたパフォーマンスを示し、さらなる一般化のために個々の視線動きの標準化を
評価
論文タイトル:A Preliminary Investigation on Eye Gaze-based Concentration Recognition during Silent Reading of Text(ポスター)
論文掲載雑誌名:ETRA '22(ACM Symposium on Eye Tracking Research and Applications)
論文発行年月:202206
# 新規性
- 黙読中の「集中(Conc)/非集中(N-conc)」状態を視線データから機械学習で識別する予備研究
- 非集中を「阻害(inhibition)」と「疲労(fatigue)」の2サブ状態で構成して扱う定式化
- Random Forest+12秒ウィンドウで F1スコア0.9超という結果を提示
# 言及されている全ての関連研究との相違点
- 先行のUema & Inoue(2017, JINS MEME)は集中レベルの「変化」を推定するにとどまるのに対し、本研究は集中/非集中の「状態分類」を行う点で差別化
- Faber et al.(2018)のmind wandering検出の特徴量設計を参照し69特徴を計算、最終的に固視(F)・サッケード(S)・瞳孔(P)由来の13種を採用
# 有効性
- 被験者13名(20代)、3条件(集中/n-back同時の阻害/疲労)、Tobii pro nanoで計測。RF+12秒窓でF1=0.902(10-fold CV_ALL)
- 個人ごとに学習する10-fold CV_INDIVではF1=0.932と高い一方、被験者横断のLOSO CVではF1=0.346と大幅に低下。個人差(読速・後戻り回数等)が原因とし、生データ標準化での改善を示唆
- サッカード関連特徴が重要度の上位6を占め、状態認識に重要と示した点は知見として有用
# 信頼性
- ETRA という視線研究の主要会議の査読付きポスター(2ページ短報)。手法・特徴量・評価指標が明確で、JSPS科研費(JP21K17787)の支援を受ける
- ただし被験者数が少なく予備段階であり、LOSO CVの低性能が示すとおり未知話者への汎化は未確立。理解度テストで読了を確認するなど手続きは妥当だが、結論は限定的
和訳
![]()
1 / 1
100%
付箋を貼る場所をクリックしてください