The Manga Whisperer: Automatically Generating Transcriptions for Comics
要約
- マンガの自動書き起こし生成モデル「Magi」の提案
- マンガにおける視覚障害者のためのアクセシビリティ向上のための取り組み
- Magiモデルは、パネル、テキストボックス、キャラクターボックスを検出し、キャラクターのクラスタリングとテキストと話者の関連付けを行い、ダイアローグの書き起こしを生成する
- 著者は、マンガの自動理解と視覚障害者への説明のためにMagiモデルを開発
- PopMangaという評価ベンチマークを作成し、80以上の人気マンガページを用いて優れた性能を実証
- 既存のパネル検出、テキスト検出、キャラクター検出、キャラクター再識別、話者識別の研究との比較を行う
- Magiアーキテクチャは、高解像度のマンガページを入力とし、CNNバックボーンによって処理され、トランスフォーマーエンコーダーデコーダーによってN [OBJ]トークンと2つの特別なトークン[ C2C]、[T2C]が生成される
- パネル、キャラクター、テキストブロックの検出と関連付けをグラフ生成問題として定式化
- Magiアーキテクチャは、パネル、テキストブロック、キャラクターを同時に検出し、キャラクター間のマッチングとテキストとキャラクターのマッチングを行う
- DETR [5]スタイルのエンコーダーデコーダートランスフォーマーによって密な特徴記述子が処理され、[OBJ]トークンと2つの特別なトークン[ C2C]、[T2C]が生成される
- 論文では、画像内の検出されたオブジェクトに対応するトークンが処理され、文字一致モジュールと話者関連モジュールによって処理されます。これにより、文字クラスターと話者関連が生成されます。
- 論文での主な設計選択肢は、「コンテキスト内」の検出と関連付けを行うことです。これに対して、以前の方法は、キャラクター再識別において、キャラクターのクロップ上で動作し、メトリック学習を使用して類似性スコアを計算するという点で制限されています。
- アーキテクチャの詳細によると、バックボーンは畳み込みニューラルネットワーク(CNN)で、トランスフォーマーエンコーダとトランスフォーマーデコーダが使用され、それぞれDET-styleトランスフォーマーエンコーダと条件付きクロスアテンションが適用されています。また、検出ヘッド、クロップ埋め込みモジュール、文字一致モジュール、話者関連モジュールなどの詳細が説明されています。
- トレーニングでは、2段階でモデルを訓練し、Mangadex-1.5MとPopManga Devサブセットを使用して、監督付きでモデルを訓練します。
- テキストボックスの並べ替えには、前の方法とは異なるアルゴリズムが提案されており、パネルの順序付けにはトポロジカルソーティングが適用されます。
- OCRの実行については、カスタム合成データを使用してTrOCRモデルをファインチューニングし、これによりテキストのコンテンツが抽出されます。
- 論文では、Manga109という既存のデータセットに加えて、新しいデータセットであるPopMangaとMangadex-1.5Mについて説明されています。これらのデータセットには、パネル、テキストブロック、キャラクターの境界ボックス、キャラクタークラスター、およびテキストスピーカー関連の注釈が含まれています。
(※注意:日本語訳は論文の一部のため、文脈が完全でない可能性があります。)
- Test-U は、モデルがトレーニング中に一度も見たことのない 10 シリーズからの 20 章で構成されています。Test-S と Test-U の画像は、公共のベンチマークとして機能することを意図しています。これらは、集英社の Manga Plus で公開されているフリーで公式な章から取得されており、将来の学術研究と比較を可能にしています。
- Manga109 は、109 巻にわたる 21,000 枚以上の画像からなる既存のデータセットで、必要なすべての検出および関連付けの注釈を提供しています。しかし、本研究では Manga109 で利用できない英語版のマンガのダイアリゼーションに主に関心があります。したがって、Manga109 は一部の評価目的にのみ使用されます。
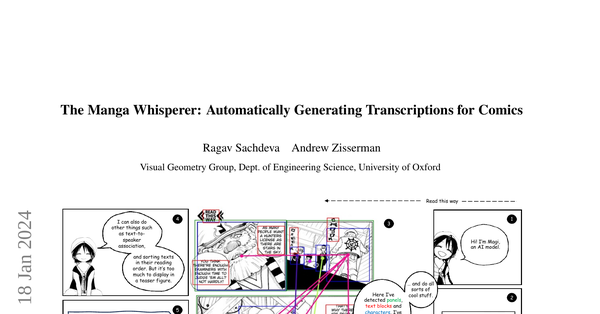
- 図 4 は、Magi モデルによるキャラクター、テキストブロック、パネルのバウンディングボックス予測およびクラスタリング予測(ノードおよびエッジとして)を示しています。モデルは、遮蔽/部分的な可視性(女の子:A4、手:B1)、視点の変化(少年:A5、女の子:A2)、および忠実度の変化(女の子:A1、少年:B2)にもかかわらず、キャラクターを正常に一致させたことに留意してください。モデルは非人間のキャラクター(犬のような生物:A1、タコのような生物:B3)も検出できます。また、モデルが誤って2つの異なるキャラクターを一致させた失敗例も示しています。
- 図 5 は、Magi モデルによって生成されたテキストからスピーカーへの予測を示しています。各予測テキストボックスは、予測されたキャラクターボックスと直線で接続されています。線の不透明度はモデルの信頼度を反映しており、より濃い線ほどモデルの信頼度が高いことを示しています。すべてのダイアローグは正しい読み順にあります。信頼度スコアが低い(<0.4)テキストからスピーカーへの予測については、生成された転写において予測されたスピーカーを ⟨?⟩
- この論文の一部には、複数のメトリクスを使用した結果が報告されており、それらはすべて1.0の上限値を持っています。
- "Character Clustering Results"と題されたテーブル3では、いくつかの方法による結果が報告されています。その中で、最も注目すべきメトリクスはAMIであり、これによってクラスタリングのパフォーマンスとモデルの意思決定の能力が評価されます。
- "Speaker Association Results"と題されたテーブル4では、Recall@#textの結果が報告されており、これも1.0の上限値を持っています。
- モデルは、テキストとパネルの検出のタスクにおいて、既存のソリューションと比較して優れた性能を発揮しました。キャラクターについては、モデルのパフォーマンスは、DASS [46]に匹敵し、3つのテストセットのうち2つでそれを上回る結果を出し、残りの1つではわずかに譲歩しました。
- キャラクタークラスタリングにおいて、モデルの最も大きな強みは、「コンテキスト内」でのキャラクタークラスタリングを行う能力であり、すべてのメトリクスとテストセットで最先端のソリューションとしての地位を確立しました。
- この研究の主な目的は、視覚障害を持つ個人にとってのマンガのアクセシビリティを向上させることであり、マンガコンテンツの完全自動転記を可能にすることで、誰もが積極的に参加できるようにすることです。
- 今後の研究では、大規模言語モデル(LLMs)の言語理解能力を活用し、会話の履歴と文脈を組み込むことで、ダイアライゼーションを向上させることを期待しています。
- 2021年3月4日に発表された研究によると、研究者たちは漫画のパネルを順序づけるための新しい手法を提案している。この手法では、パネルを読む順序を表す有向非巡回グラフ(DAG)を構築し、それに基づいて読む順序を決定している。パネル同士の相対的な読む順序を決定する際には、パネルの位置関係を考慮しており、重なっている場合には形態学的浸食を用いて相対的な順序を決定している。また、この手法を用いて、漫画の章を複数のセットに分割し、それぞれのセットに含まれる漫画のリストを示している。
- PopMangaは、マンガの各ページについてテキストボックス、キャラクターボックス、キャラクター間のポジティブペア、テキストとキャラクターのポジティブペアをアノテーションするための指示を与えた。
- PopMangaのアノテーションプロセスは、13人のアノテーターによって行われ、テキストとキャラクターのマッチングが最も難しいタスクであった。
- PopMangaのアノテーションツールは、LISAアノテーションツールの改良版であり、バウンディングボックス、キャラクター間の関連、テキストとキャラクターの関連を簡単にアノテーションできるようにしたものである。
- PopMangaのアノテーションは、Manga109と比較していくつかの違いがある。例えば、テキストボックスの扱い、キャラクターの一意のIDの有無、追加のアノテーションなどが挙げられる。
- キャラクタークラスタリングの評価プロセスについて、Magiとベースラインの比較、メトリクスの実装、OCRの適応について説明がされている。
評価
論文は、マンガの自動書き起こし生成モデル「Magi」を提案しています。Magiは、視覚障害者がマンガを理解するのを助けることを目指しており、パネル、テキストボックス、キャラクターボックスを検出し、キャラクターのクラスタリングとテキストと話者の関連付けを行います。これはマンガのダイアローグの書き起こし生成を可能にします。
性能評価のために、著者はPopMangaという評価ベンチマークを作成し、80以上の人気マンガページを使用して性能を実証しました。さらに、既存の様々な研究と比較しました。
Magiアーキテクチャは、高解像度のマンガページを入力とし、CNNバックボーンによって処理され、トランスフォーマーエンコーダーデコーダーによって特別なトークンを生成します。これにより、パネル、キャラクター、テキストブロックの検出と関連付けが可能となります。
主な設計選択肢は、「コンテキスト内」の検出と関連付けの実行で、これにより以前の手法が持っていた制限を克服しています。アーキテクチャの詳細では、バックボーンは畳み込みニューラルネットワーク(CNN)を使用し、さらにトランスフォーマーエンコーダとトランスフォーマーデコーダも使用しています。
要約:
本研究は、Mangadex-1.5MとPopManga Devサブセットを用いた2段階のモデル訓練、新たなテキストボックス並べ替えアルゴリズム、及びカスタム合成データを用いたTrOCRモデルのファインチューニングについて述べています。新旧のデータセット、Manga109と新設のPopMangaとMangadex-1.5Mが使用され、これらには各種注釈が含まれています。また、未見のシリーズからの章を含むTest-Uという公共のベンチマークも紹介されています。Manga109は既存のデータセットで、英語版マンガのダイアリゼーションに焦点を当てていますが、一部の評価目的のみに使用されます。最後に、Magiモデルの予測結果が図示され、その精度が示されています。
この研究では、視覚障害者のためのマンガのアクセシビリティを向上させるために、Magiモデルが用いられています。このモデルはテキストとパネルの検出に成功し、特に「コンテキスト内」のキャラクタークラスタリングにおいて最先端の結果を示しました。モデルの信頼度は、線の不透明度で表示され、高信頼度の予測は濃い線で示されます。モデルはいくつかの場合でキャラクターを誤って一致させたが、全体的には高いパフォーマンスを達成しました。論文には複数のメトリクスに基づく結果が報告されており、AMIとRecall@#textは特に注目すべき指標とされました。全体的な目標は、マンガのコンテンツを自動転写することで、全ての人々がアクセスできるようにすることです。今後の研究では、大規模言語モデルを活用し、会話の履歴と文脈を組み込むことで、ダイアログ生成をさらに改善することを期待しています。
この研究は、漫画のパネルを順序付ける新しい手法を提案しています。パネルを読む順序を示す有向非巡回グラフ(DAG)を作り、パネルの相対的な順序を決定します。重なりがある場合は形態学的浸食を利用します。また、漫画を章ごとにセットに分けてリスト化します。
PopMangaは、漫画の各ページに対するアノテーションを行います。13人のアノテーターがテキストとキャラクターのマッチングを行い、これが最も難易度の高いタスクでした。使用したアノテーションツールは、LISAアノテーションツールの改良版で、キャラクター間の関連性やテキストとキャラクターの関連性を容易に扱えます。
PopMangaのアノテーションは、Manga109といくつかの点で異なります。これには、テキストボックスの扱い、キャラクターの一意のIDの有無、追加のアノテーションが含まれます。
さらに、キャラクタークラスタリングの評価プロセスについて、Magiとベースラインとの比較、メトリクスの実装、OCRの適応について説明しています。
和訳
![]()
1 / 1
100%
付箋を貼る場所をクリックしてください